В цикле · S1E06 Жизненный цикл агента
Evals: как доказать, что агент работает
От разборов ошибок до автоматических проверок и A/B-тестов: строим систему оценки, которая помогает улучшать продукт.
Демо может выглядеть убедительно, а продукт — ломаться на соседнем запросе. После очередной правки промпта исправленная ошибка исчезает, но появляется другая. Если команда проверяет только несколько знакомых примеров, она не видит, стало ли лучше в целом.
Шестой выпуск «В цикле» посвящён продуктовым evals — системе оценки на задачах своих пользователей. Основа выпуска — подход Хамела Хусейна из Your AI Product Needs Evals. Здесь разберём, как превратить наблюдения за ошибками в повторяемый процесс улучшения.
Что именно считать качеством
Общий бенчмарк помогает сравнить способности моделей. Продуктовая оценка отвечает на другой вопрос: выполнила ли конкретная система задачу пользователя с нужными ограничениями?
У помощника поддержки это может означать: найден правильный заказ, не раскрыты чужие данные, ответ соответствует фактическому статусу и не обещает несуществующий возврат. Красивый текст с неверным действием нельзя считать успехом.
Начните с нескольких важных сценариев и понятных критериев. Определите, что допустимо, что требует передачи человеку и какие ошибки неприемлемы. Не объединяйте всё сразу в одну среднюю оценку: она может скрыть серьёзную проблему в редком, но важном сценарии.
Короткий цикл улучшения
Правка промпта — только один возможный ответ на ошибку. Причина может быть в поиске, данных, описании инструмента, разрешениях, маршруте или коде. Для выбора исправления нужен трейс: последовательность входов, решений и результатов, а не только финальный ответ модели.
Каждый подтверждённый новый тип ошибки полезно превращать в проверку. Так набор оценки постепенно отражает реальную поверхность продукта и защищает от возвращения уже исправленных проблем.
Три уровня с разной стоимостью
| Уровень | Что проверяет | Когда запускать |
|---|---|---|
| Проверки кодом | Формат, допустимые действия, обязательные условия и инварианты | При каждом релевантном изменении |
| Эксперт и модель-судья | Смысл, полноту и качество выполнения задачи | На размеченном наборе и регулярных выборках |
| Продуктовый эксперимент | Изменение поведения пользователей и экономики | После подготовки и проверки значимых изменений |
Чем дороже проверка, тем важнее использовать её там, где более дешёвая не отвечает на вопрос. Для поля с допустимыми значениями не нужен LLM-судья. Для неоднозначного содержательного ответа может понадобиться эксперт. А улучшение офлайн-оценки ещё не доказывает рост полезности для пользователей.
Соберите набор вокруг сценариев
Для учебного поиска заказа можно включить обычный найденный заказ, отсутствие результата, неоднозначный номер, недоступность внешнего сервиса и попытку получить чужие сведения. Это разные ситуации с разным правильным поведением.
Синтетические входы помогают начать до появления большого потока пользователей. Но их нужно проверять на правдоподобие и постепенно дополнять реальными случаями с необходимым обезличиванием. Слишком удобные примеры быстро создают ложное чувство готовности.
Отделяйте набор, по которому улучшаете систему, от отложенной проверки. Иначе можно незаметно настроить промпт или судью на известные ответы и переоценить качество. Фиксируйте версии данных, критериев, модели, промпта и кода.
Первый уровень: проверяемые условия
Полезные проверки связаны с поведением продукта: не вызван запрещённый инструмент, сумма соответствует данным заказа, обязательное поле присутствует, внутренний идентификатор не показан пользователю. Тест, который просто повторяет текущую реализацию, мало защищает от неправильного решения задачи.
Сценарий: заказ не найден

Проверить:
— нет вызова инструмента возврата;
— нет выдуманной даты доставки;
— запрошено уточнение или предложен допустимый следующий шаг;
— завершение не помечено как успешно выполненный возврат.
Часть этих условий легко проверить кодом, часть требует оценки смысла. Их лучше разделить, чтобы было понятно, где именно система ошиблась и насколько надёжна сама проверка.
Сделайте просмотр трейсов удобным
Эксперту нужны на одном экране запрос, факты, вызовы инструментов, итог и критерий оценки. Если для каждого примера приходится открывать несколько систем и искать запись вручную, проверка быстро становится редкой и поверхностной.
Начать можно с бинарной разметки «приемлемо / неприемлемо» и короткой причины. Несогласие разметчиков — полезный сигнал: возможно, критерий неоднозначен или в продукте нет решения для такого случая.
Самая ценная часть часто находится в объяснении ошибки. Оно помогает отличить неверные данные от плохого выбора действия и превращается в материал для следующей проверки.
Модель-судью тоже нужно оценивать
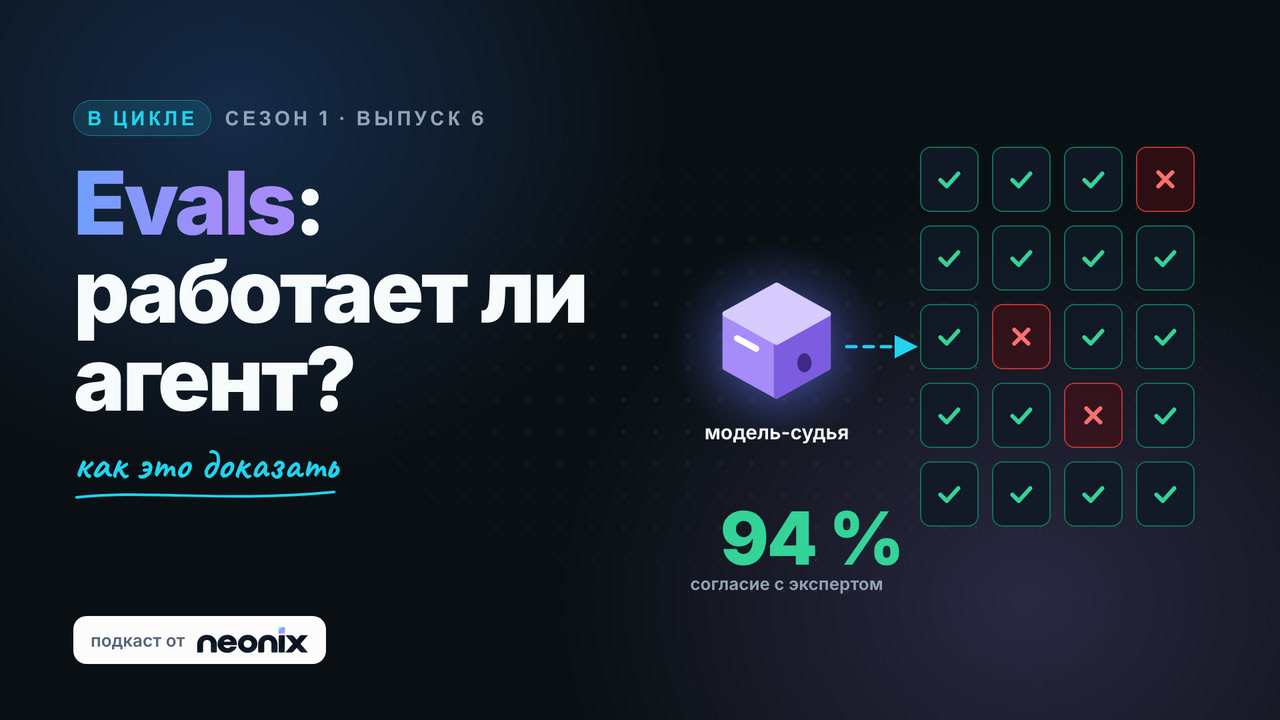
Судья позволяет быстрее проверять больше примеров, но его вердикт не становится истиной автоматически. Сначала сравните его с экспертной разметкой. Отдельно разберите пропущенные плохие ответы и ошибочно отклонённые хорошие.
Учебный пример: из ста ответов девяносто пять хорошие. Судья, который всегда говорит «хорошо», покажет 95% совпадений и не обнаружит ни одной ошибки. Поэтому одной доли согласия недостаточно. Для класса ошибок смотрите precision и recall, а также их поведение по сценариям.
Судья не должен получать нежелательные подсказки о варианте модели или ожидаемом победителе. Его критерии, промпт и контрольный набор нужно версионировать. После изменения продукта прежнюю калибровку следует перепроверить.
Что добавляет A/B-тест
Офлайн-проверки показывают, что изменение выглядит допустимым на выбранных данных. Эксперимент помогает оценить, влияет ли оно на решение задач, повторные обращения, конверсию или стоимость обслуживания в реальном продукте.
До запуска определите основную метрику и ограничения: например, время ответа, долю ошибок и эскалаций. Не следует считать любой рост числа автоматических ответов улучшением, если пользователи чаще возвращаются с нерешённой проблемой.
Развитая система оценки одновременно становится инструментом отладки: жалоба связывается с трейсом, причина — с изменением, а изменение — с проверкой до релиза. Это особенно важно, когда в продакшене меняются модели и маршруты.
Источники
Статья подготовлена по главе 7 материалов «Жизненный цикл агента» и сценарию S1E06. Основной источник — Hamel Husain: Your AI Product Needs Evals. Примеры с заказами и несбалансированной выборкой в этой статье — учебные пояснения подхода.