В цикле · S2E01 Под нагрузкой
Язык нагрузки: задержка, перцентили и хвосты
Почему средняя задержка скрывает проблемы, как fan-out усиливает хвосты и что закон Литтла говорит о числе запросов в работе.
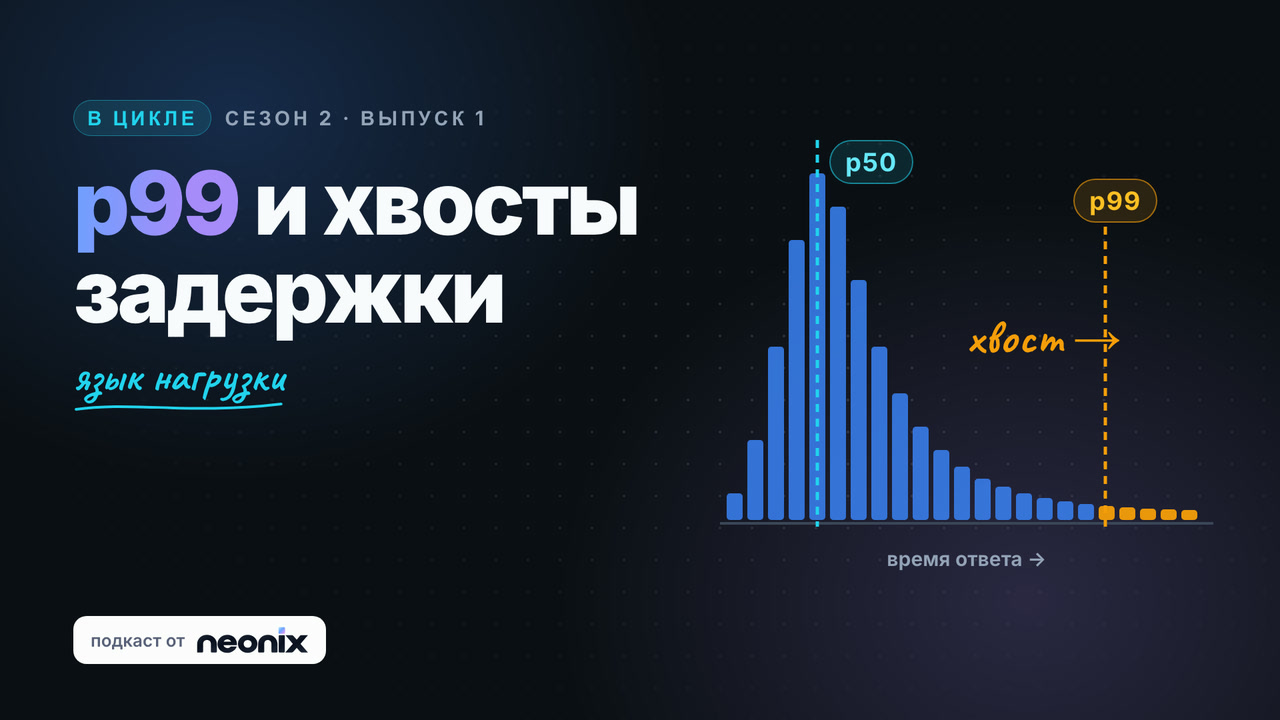
Сервис отвечает в среднем быстро, но пользователи всё равно жалуются на ожидание. При добавлении параллельных запросов проблема иногда усиливается. Чтобы разобраться, нужны распределения задержки, границы измерения и понимание того, сколько работы одновременно находится внутри системы.
Первый выпуск второго сезона «В цикле» открывает серию «Под нагрузкой». Его основа — The Tail at Scale, глава Google SRE о целях обслуживания и материалы по проектированию систем. Все расчёты ниже — иллюстрации, а не показатели инфраструктуры neonix.
Задержка и пропускная способность
Latency — время выполнения одной операции. Throughput — число завершённых операций за единицу времени. Сервис может обрабатывать много запросов в секунду и при этом заставлять каждого пользователя долго ждать.
Определите границы измерения. Время внутри обработчика не включает очередь перед ним. Время вызова модели не включает поиск данных и инструменты. Пользователю важно время от его действия до пригодного результата; внутренние измерения нужны, чтобы объяснить, из чего оно складывается.
Для AI-продукта полезно отдельно смотреть время до первого ответа и до завершения задачи. Быстрый первый токен не компенсирует долгий цикл инструментов, если результат можно использовать только в конце.
Почему одного среднего мало
Представим, что 95 запросов занимают 50 мс, а ещё пять — по секунде. Среднее составит 97,5 мс. Оно описывает выборку, но не показывает, что часть пользователей ждёт в двадцать раз дольше обычного.
p50 характеризует середину распределения. p99 — порог, в который укладывается примерно 99% наблюдений. Остальные образуют хвост. Это не максимальная задержка и не обещание, что следующий запрос обязательно будет быстрее.
Высокие перцентили требуют достаточного числа наблюдений. У редкого endpoint часовой p99 может быть нестабильным. Кроме того, нельзя получить общий p99 простым усреднением p99 отдельных серверов: для объединения нужны сами распределения или совместимые гистограммы.
Измеряйте отдельно разные классы запросов, успешные ответы и ошибки. Быстрые отказы способны улучшить среднюю задержку одновременно с ухудшением работы продукта.
SLI измеряет, SLO задаёт цель
SLI — определённый показатель обслуживания. SLO — целевое значение этого показателя на заданном окне. SLA добавляет соглашение с последствиями невыполнения. Назвать график «SLA» ещё не значит сформулировать договорённость.
Учебная цель может звучать так: «За 30 дней не менее 99% допустимых запросов поиска завершаются успешным ответом быстрее 500 мс». Здесь есть операция, результат, порог, доля и окно. На практике также нужно определить, какие запросы входят в расчёт и где измеряется время.
Порог берут из потребности пользователя и экономики сервиса, а не копируют из красивого графика. Допустимая доля нарушений задаёт бюджет ошибок. Он помогает обсуждать компромисс между изменениями и надёжностью на конкретных данных.
Fan-out: редкий медленный ответ становится обычным
Представим запрос, который обращается к ста независимым компонентам и ждёт все ответы. Каждый компонент с вероятностью 99% отвечает быстро. Вероятность, что быстро ответят все, равна 0,99¹⁰⁰ ≈ 0,366. Значит, хотя бы один медленный ответ встретится примерно в 63% таких запросов.
Вероятность хотя бы одного медленного ответа = 1 − (1 − p)ⁿ

p — вероятность медленного ответа одного компонента
n — число независимых компонентов

При p = 0,01 и n = 100: примерно 63%
Расчёт предполагает независимость задержек и ожидание всех компонентов. В реальной системе общие зависимости, перегрузка или сеть могут сделать задержки коррелированными. Поэтому формула объясняет эффект, но не заменяет измерение вашей архитектуры.
Для агента аналогичный риск возникает, когда он параллельно запрашивает много источников и не продолжает работу, пока не получит последний ответ. Параллельность уменьшает последовательное ожидание, но повышает вероятность встретить медленного участника.
Откуда берутся хвосты
Источники разброса часто находятся вне основной бизнес-логики: конкуренция за CPU и сеть, сборка мусора, фоновые задачи, очереди, медленное хранилище и перегруженная зависимость. На рост нагрузки система может отвечать нелинейным увеличением ожидания.
Начните с трассировки по этапам и отделите время очереди от времени обслуживания. Проверьте, не блокируют ли дорогие запросы короткие и не конкурируют ли пользовательские операции с пакетной обработкой. Увеличение числа процессов не поможет, если ограничение находится в общей базе или внешнем лимите.
Как работать с хвостом
Первая группа мер уменьшает разброс: ограничение очередей, разделение классов обслуживания, контроль фоновой нагрузки и устранение блокировки коротких задач длинными. Вторая помогает пережить оставшуюся вариативность.
При хеджировании копия запроса отправляется другой реплике после небольшой задержки, а приложение использует первый пригодный ответ. При связанных запросах копии координируют отмену, когда одна начинает исполнение. Обе техники требуют учёта дополнительной нагрузки и поведения отмены.
Это не универсальный способ ускорить записи. Дублирование платежа или отправки письма создаёт другой класс ошибок. Для операций с последствиями сначала нужна корректная семантика идемпотентности. Даже чтения опасно бездумно дублировать во время общей перегрузки: так можно усугубить её.
Иногда продукт допускает частичный результат без необязательного источника. Тогда это должно быть явным решением: что можно пропустить, как обозначить неполноту и где без всех ответов продолжать нельзя.
Закон Литтла: сколько запросов находится в работе
Для устойчивой системы на сопоставимом интервале среднее число запросов внутри связано со скоростью потока и средним временем пребывания:
L = λ × W

50 запросов/с × 4 с = 200 запросов в системе в среднем
Если задержка вырастет до восьми секунд при том же потоке, среднее число запросов увеличится до четырёхсот. Это могут быть не четыре сотни занятых CPU: в асинхронном сервисе многие запросы ждут сеть. Но они занимают память, соединения, лимиты и место в очередях.
Используйте согласованные единицы и одинаковые границы. Если W включает очередь, L тоже включает ожидающие запросы. В формулу подставляют средние, а не p99. Если очередь непрерывно растёт, система не находится в устойчивом режиме, и такая прикидка не доказывает достаточность ресурсов.
С чего начать измерения
- Выберите пользовательскую операцию и определите начало и конец её измерения.
- Собирайте поток, ошибки, распределение задержки и число запросов в работе.
- Разделите ожидание очереди, собственную обработку и внешние зависимости.
- Проверьте разные уровни нагрузки и поведение около насыщения.
- Сформулируйте SLO, который отражает пригодность результата для пользователя.
Для LLM-сервиса эти измерения дополняют маршрутизацию и резервирование. Быстрый ответ должен оставаться корректным, поэтому производительность оценивают вместе с качеством решения задачи.
Источники
Статья подготовлена по первой главе «Под нагрузкой» и сценарию S2E01. Численные примеры служат объяснению принципов.